多线程1
什么是线程和进程?
何为进程?
进程是程序的一次执行过程,是系统运行程序的基本单位,因此进程是动态的。系统运行一个程序即是一个进程从创建,运行到消亡的过程。
在 Java 中,当我们启动 main 函数时其实就是启动了一个 JVM 的进程,而 main 函数所在的线程就是这个进程中的一个线程,也称主线程。
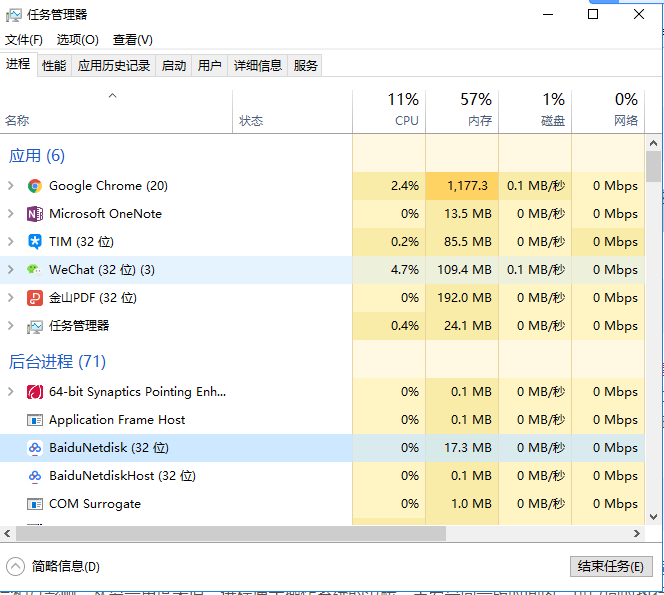
如下图所示,在 windows 中通过查看任务管理器的方式,我们就可以清楚看到 window 当前运行的进程(.exe 文件的运行)。
何为线程?
线程与进程相似,但线程是一个比进程更小的执行单位。一个进程在其执行的过程中可以产生多个线程。与进程不同的是同类的多个线程共享进程的堆和方法区资源,但每个线程有自己的程序计数器、虚拟机栈和本地方法栈,所以系统在产生一个线程,或是在各个线程之间作切换工作时,负担要比进程小得多,也正因为如此,线程也被称为轻量级进程。
Java 程序天生就是多线程程序,我们可以通过 JMX 来看一下一个普通的 Java 程序有哪些线程,代码如下。
1 | public class MultiThread { |
上述程序输出如下(输出内容可能不同,不用太纠结下面每个线程的作用,只用知道 main 线程执行 main 方法即可):
1 | [5] Attach Listener //添加事件 |
从上面的输出内容可以看出:一个 Java 程序的运行是 main 线程和多个其他线程同时运行。
请简要描述线程与进程的关系,区别及优缺点?
从 JVM 角度说进程和线程之间的关系
图解进程和线程的关系
下图是 Java 内存区域,通过下图我们从 JVM 的角度来说一下线程和进程之间的关系。

从上图可以看出:一个进程中可以有多个线程,多个线程共享进程的堆和方法区 (JDK1.8 之后的元空间)资源,但是每个线程有自己的程序计数器、虚拟机栈 和 本地方法栈。
总结: 线程是进程划分成的更小的运行单位。线程和进程最大的不同在于基本上各进程是独立的,而各线程则不一定,因为同一进程中的线程极有可能会相互影响。线程执行开销小,但不利于资源的管理和保护;而进程正相反。
下面是该知识点的扩展内容!
下面来思考这样一个问题:为什么程序计数器、虚拟机栈和本地方法栈是线程私有的呢?为什么堆和方法区是线程共享的呢?
程序计数器为什么是私有的?
程序计数器主要有下面两个作用:
- 字节码解释器通过改变程序计数器来依次读取指令,从而实现代码的流程控制,如:顺序执行、选择、循环、异常处理。
- 在多线程的情况下,程序计数器用于记录当前线程执行的位置,从而当线程被切换回来的时候能够知道该线程上次运行到哪儿了。
需要注意的是,如果执行的是 native 方法,那么程序计数器记录的是 undefined 地址,只有执行的是 Java 代码时程序计数器记录的才是下一条指令的地址。
所以,程序计数器私有主要是为了线程切换后能恢复到正确的执行位置。
虚拟机栈和本地方法栈为什么是私有的?
- 虚拟机栈: 每个 Java 方法在执行的同时会创建一个栈帧用于存储局部变量表、操作数栈、常量池引用等信息。从方法调用直至执行完成的过程,就对应着一个栈帧在 Java 虚拟机栈中入栈和出栈的过程。
- 本地方法栈: 和虚拟机栈所发挥的作用非常相似,区别是: 虚拟机栈为虚拟机执行 Java 方法 (也就是字节码)服务,而本地方法栈则为虚拟机使用到的 Native 方法服务。 在 HotSpot 虚拟机中和 Java 虚拟机栈合二为一。
所以,为了保证线程中的局部变量不被别的线程访问到,虚拟机栈和本地方法栈是线程私有的。
一句话简单了解堆和方法区
堆和方法区是所有线程共享的资源,其中堆是进程中最大的一块内存,主要用于存放新创建的对象 (几乎所有对象都在这里分配内存),方法区主要用于存放已被加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。
说说并发与并行的区别?
- 并发: 同一时间段,多个任务都在执行 (单位时间内不一定同时执行);
- 并行: 单位时间内,多个任务同时执行。
为什么要使用多线程呢?
先从总体上来说:
- 从计算机底层来说: 线程可以比作是轻量级的进程,是程序执行的最小单位,线程间的切换和调度的成本远远小于进程。另外,多核 CPU 时代意味着多个线程可以同时运行,这减少了线程上下文切换的开销。
- 从当代互联网发展趋势来说: 现在的系统动不动就要求百万级甚至千万级的并发量,而多线程并发编程正是开发高并发系统的基础,利用好多线程机制可以大大提高系统整体的并发能力以及性能。
再深入到计算机底层来探讨:
- 单核时代: 在单核时代多线程主要是为了提高单进程利用 CPU 和 IO 系统的效率。 假设只运行了一个 Java 进程的情况,当我们请求 IO 的时候,如果 Java 进程中只有一个线程,此线程被 IO 阻塞则整个进程被阻塞。CPU 和 IO 设备只有一个在运行,那么可以简单地说系统整体效率只有 50%。当使用多线程的时候,一个线程被 IO 阻塞,其他线程还可以继续使用 CPU。从而提高了 Java 进程利用系统资源的整体效率。
- 多核时代: 多核时代多线程主要是为了提高进程利用多核 CPU 的能力。举个例子:假如我们要计算一个复杂的任务,我们只用一个线程的话,不论系统有几个 CPU 核心,都只会有一个 CPU 核心被利用到。而创建多个线程,这些线程可以被映射到底层多个 CPU 上执行,在任务中的多个线程没有资源竞争的情况下,任务执行的效率会有显著性的提高,约等于(单核时执行时间/CPU 核心数)。
使用多线程可能带来什么问题?
并发编程的目的就是为了能提高程序的执行效率提高程序运行速度,但是并发编程并不总是能提高程序运行速度的,而且并发编程可能会遇到很多问题,比如:内存泄漏、死锁、线程不安全等等。
什么是上下文切换?
线程在执行过程中会有自己的运行条件和状态(也称上下文),比如上文所说到过的程序计数器,栈信息等。当出现如下情况的时候,线程会从占用 CPU 状态中退出。
- 主动让出 CPU,比如调用了
sleep(),wait()等。 - 时间片用完,因为操作系统要防止一个线程或者进程长时间占用CPU导致其他线程或者进程饿死。
- 调用了阻塞类型的系统中断,比如请求 IO,线程被阻塞。
- 被终止或结束运行
这其中前三种都会发生线程切换,线程切换意味着需要保存当前线程的上下文,留待线程下次占用 CPU 的时候恢复现场。并加载下一个将要占用 CPU 的线程上下文。这就是所谓的 上下文切换。
上下文切换是现代操作系统的基本功能,因其每次需要保存信息恢复信息,这将会占用 CPU,内存等系统资源进行处理,也就意味着效率会有一定损耗,如果频繁切换就会造成整体效率低下。
什么是线程死锁?如何避免死锁?
认识线程死锁
线程死锁描述的是这样一种情况:多个线程同时被阻塞,它们中的一个或者全部都在等待某个资源被释放。由于线程被无限期地阻塞,因此程序不可能正常终止。
如下图所示,线程 A 持有资源 2,线程 B 持有资源 1,他们同时都想申请对方的资源,所以这两个线程就会互相等待而进入死锁状态。
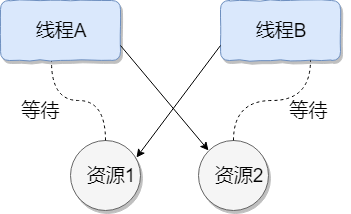
下面通过一个例子来说明线程死锁,代码模拟了上图的死锁的情况 (代码来源于《并发编程之美》):
1 | public class DeadLockDemo { |
Output
1 | Thread[线程 1,5,main]get resource1 |
线程 A 通过 synchronized (resource1) 获得 resource1 的监视器锁,然后通过Thread.sleep(1000);让线程 A 休眠 1s 为的是让线程 B 得到执行然后获取到 resource2 的监视器锁。线程 A 和线程 B 休眠结束了都开始企图请求获取对方的资源,然后这两个线程就会陷入互相等待的状态,这也就产生了死锁。上面的例子符合产生死锁的四个必要条件。
学过操作系统的朋友都知道产生死锁必须具备以下四个条件:
- 互斥条件:该资源任意一个时刻只由一个线程占用。
- 请求与保持条件:一个进程因请求资源而阻塞时,对已获得的资源保持不放。
- 不剥夺条件:线程已获得的资源在未使用完之前不能被其他线程强行剥夺,只有自己使用完毕后才释放资源。
- 循环等待条件:若干进程之间形成一种头尾相接的循环等待资源关系。
如何预防和避免线程死锁?
如何预防死锁? 破坏死锁的产生的必要条件即可:
- 破坏请求与保持条件 :一次性申请所有的资源。
- 破坏不剥夺条件 :占用部分资源的线程进一步申请其他资源时,如果申请不到,可以主动释放它占有的资源。
- 破坏循环等待条件 :靠按序申请资源来预防。按某一顺序申请资源,释放资源则反序释放。破坏循环等待条件。
如何避免死锁?
避免死锁就是在资源分配时,借助于算法(比如银行家算法)对资源分配进行计算评估,使其进入安全状态。
安全状态 指的是系统能够按照某种进程推进顺序(P1、P2、P3…..Pn)来为每个进程分配所需资源,直到满足每个进程对资源的最大需求,使每个进程都可顺利完成。称<P1、P2、P3…..Pn>序列为安全序列。
我们对线程 2 的代码修改成下面这样就不会产生死锁了。
1 | new Thread(() -> { |
Output
1 | Thread[线程 1,5,main]get resource1 |
我们分析一下上面的代码为什么避免了死锁的发生?
线程 1 首先获得到 resource1 的监视器锁,这时候线程 2 就获取不到了。然后线程 1 再去获取 resource2 的监视器锁,可以获取到。然后线程 1 释放了对 resource1、resource2 的监视器锁的占用,线程 2 获取到就可以执行了。这样就破坏了破坏循环等待条件,因此避免了死锁。
创建或者启动线程的几种方式
总:
一共有三种方式
继承Thread类
实现Runnable接口
实现CallAble接口
分:
继承Thread类:
使用继承的方法,一般不使用这种,因为java使用单继承
实现Runnable接口
使用接口的方法,但是这种的run方法是没有返回值的
实现CallAble接口
使用接口的方法,这种call方法可以有返回值
1 | /** |
线程池
一 使用线程池的好处
池化技术想必大家已经屡见不鲜了,线程池、数据库连接池、Http 连接池等等都是对这个思想的应用。池化技术的思想主要是为了减少每次获取资源的消耗,提高对资源的利用率。
线程池提供了一种限制和管理资源(包括执行一个任务)。 每个线程池还维护一些基本统计信息,例如已完成任务的数量。
这里借用《Java 并发编程的艺术》提到的来说一下使用线程池的好处:
- 降低资源消耗。通过重复利用已创建的线程降低线程创建和销毁造成的消耗。
- 提高响应速度。当任务到达时,任务可以不需要等到线程创建就能立即执行。
- 提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。
二 Executor 框架
2.1 简介
Executor 框架是 Java5 之后引进的,在 Java 5 之后,通过 Executor 来启动线程比使用 Thread 的 start 方法更好,除了更易管理,效率更好(用线程池实现,节约开销)外,还有关键的一点:有助于避免 this 逃逸问题。
补充:this 逃逸是指在构造函数返回之前其他线程就持有该对象的引用. 调用尚未构造完全的对象的方法可能引发令人疑惑的错误。
Executor 框架不仅包括了线程池的管理,还提供了线程工厂、队列以及拒绝策略等,Executor 框架让并发编程变得更加简单。
2.2 Executor 框架结构(主要由三大部分组成)
1) 任务(Runnable /Callable)
执行任务需要实现的 Runnable 接口 或 Callable接口。**Runnable 接口**或 Callable 接口 实现类都可以被 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行。
2) 任务的执行(Executor)
如下图所示,包括任务执行机制的核心接口 Executor ,以及继承自 Executor 接口的 ExecutorService 接口。ThreadPoolExecutor 和 ScheduledThreadPoolExecutor 这两个关键类实现了 ExecutorService 接口。
这里提了很多底层的类关系,但是,实际上我们需要更多关注的是 ThreadPoolExecutor 这个类,这个类在我们实际使用线程池的过程中,使用频率还是非常高的。
注意: 通过查看
ScheduledThreadPoolExecutor源代码我们发现ScheduledThreadPoolExecutor实际上是继承了ThreadPoolExecutor并实现了 ScheduledExecutorService ,而ScheduledExecutorService又实现了ExecutorService,正如我们下面给出的类关系图显示的一样。
ThreadPoolExecutor 类描述:
1 | //AbstractExecutorService实现了ExecutorService接口 |
ScheduledThreadPoolExecutor 类描述:
1 | //ScheduledExecutorService继承ExecutorService接口 |

3) 异步计算的结果(Future)
Future 接口以及 Future 接口的实现类 FutureTask 类都可以代表异步计算的结果。
当我们把 Runnable接口 或 Callable 接口 的实现类提交给 ThreadPoolExecutor 或 ScheduledThreadPoolExecutor 执行。(调用 submit() 方法时会返回一个 FutureTask 对象)
2.3 Executor 框架的使用示意图

- 主线程首先要创建实现
Runnable或者Callable接口的任务对象。 - 把创建完成的实现
Runnable/Callable接口的 对象直接交给ExecutorService执行:ExecutorService.execute(Runnable command))或者也可以把Runnable对象或Callable对象提交给ExecutorService执行(ExecutorService.submit(Runnable task)或ExecutorService.submit(Callable <T> task))。 - 如果执行
ExecutorService.submit(…),ExecutorService将返回一个实现Future接口的对象(我们刚刚也提到过了执行execute()方法和submit()方法的区别,submit()会返回一个FutureTask 对象)。由于 FutureTask实现了Runnable,我们也可以创建FutureTask,然后直接交给ExecutorService执行。 - 最后,主线程可以执行
FutureTask.get()方法来等待任务执行完成。主线程也可以执行FutureTask.cancel(boolean mayInterruptIfRunning)来取消此任务的执行。
三 (重要)ThreadPoolExecutor 类简单介绍
线程池实现类 ThreadPoolExecutor 是 Executor 框架最核心的类。
3.1 ThreadPoolExecutor 类分析
ThreadPoolExecutor 类中提供的四个构造方法。我们来看最长的那个,其余三个都是在这个构造方法的基础上产生(其他几个构造方法说白点都是给定某些默认参数的构造方法比如默认制定拒绝策略是什么)。
1 | /** |
下面这些对创建非常重要,在后面使用线程池的过程中你一定会用到!所以,务必拿着小本本记清楚。
ThreadPoolExecutor 3 个最重要的参数:
corePoolSize: 核心线程数线程数定义了最小可以同时运行的线程数量。maximumPoolSize: 当队列中存放的任务达到队列容量的时候,当前可以同时运行的线程数量变为最大线程数。workQueue: 当新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
ThreadPoolExecutor其他常见参数 :
keepAliveTime:当线程池中的线程数量大于corePoolSize的时候,如果这时没有新的任务提交,核心线程外的线程不会立即销毁,而是会等待,直到等待的时间超过了keepAliveTime才会被回收销毁;unit:keepAliveTime参数的时间单位。threadFactory:executor 创建新线程的时候会用到。handler:饱和策略。关于饱和策略下面单独介绍一下。
下面这张图可以加深你对线程池中各个参数的相互关系的理解(图片来源:《Java 性能调优实战》):

ThreadPoolExecutor 饱和策略定义:
如果当前同时运行的线程数量达到最大线程数量并且队列也已经被放满了任务时,ThreadPoolTaskExecutor 定义一些策略:
ThreadPoolExecutor.AbortPolicy:抛出RejectedExecutionException来拒绝新任务的处理。ThreadPoolExecutor.CallerRunsPolicy:调用执行自己的线程运行任务,也就是直接在调用execute方法的线程中运行(run)被拒绝的任务,如果执行程序已关闭,则会丢弃该任务。因此这种策略会降低对于新任务提交速度,影响程序的整体性能。如果您的应用程序可以承受此延迟并且你要求任何一个任务请求都要被执行的话,你可以选择这个策略。ThreadPoolExecutor.DiscardPolicy:不处理新任务,直接丢弃掉。ThreadPoolExecutor.DiscardOldestPolicy: 此策略将丢弃最早的未处理的任务请求。
举个例子:
Spring 通过
ThreadPoolTaskExecutor或者我们直接通过ThreadPoolExecutor的构造函数创建线程池的时候,当我们不指定RejectedExecutionHandler饱和策略的话来配置线程池的时候默认使用的是ThreadPoolExecutor.AbortPolicy。在默认情况下,ThreadPoolExecutor将抛出RejectedExecutionException来拒绝新来的任务 ,这代表你将丢失对这个任务的处理。 对于可伸缩的应用程序,建议使用ThreadPoolExecutor.CallerRunsPolicy。当最大池被填满时,此策略为我们提供可伸缩队列。(这个直接查看ThreadPoolExecutor的构造函数源码就可以看出,比较简单的原因,这里就不贴代码了。)
3.2 推荐使用 ThreadPoolExecutor 构造函数创建线程池
在《阿里巴巴 Java 开发手册》“并发处理”这一章节,明确指出线程资源必须通过线程池提供,不允许在应用中自行显式创建线程。
为什么呢?
使用线程池的好处是减少在创建和销毁线程上所消耗的时间以及系统资源开销,解决资源不足的问题。如果不使用线程池,有可能会造成系统创建大量同类线程而导致消耗完内存或者“过度切换”的问题。
另外,《阿里巴巴 Java 开发手册》中强制线程池不允许使用 Executors 去创建,而是通过 ThreadPoolExecutor 构造函数的方式,这样的处理方式让写的同学更加明确线程池的运行规则,规避资源耗尽的风险
Executors返回线程池对象的弊端如下(后文会详细介绍到):
FixedThreadPool和SingleThreadExecutor: 允许请求的队列长度为Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。CachedThreadPool和ScheduledThreadPool: 允许创建的线程数量为Integer.MAX_VALUE,可能会创建大量线程,从而导致 OOM。
方式一:通过ThreadPoolExecutor构造函数实现(推荐)
方式二:通过 Executor 框架的工具类 Executors 来实现
我们可以创建三种类型的 ThreadPoolExecutor:
FixedThreadPoolSingleThreadExecutor- CachedThreadPool
对应 Executors 工具类中的方法如图所示:

四 ThreadPoolExecutor 使用+原理分析
我们上面讲解了 Executor框架以及 ThreadPoolExecutor 类,下面让我们实战一下,来通过写一个 ThreadPoolExecutor 的小 Demo 来回顾上面的内容。
4.1 示例代码:Runnable+ThreadPoolExecutor
首先创建一个 Runnable 接口的实现类(当然也可以是 Callable 接口,我们上面也说了两者的区别。)
MyRunnable.java
1 | import java.util.Date; |
编写测试程序,我们这里以阿里巴巴推荐的使用 ThreadPoolExecutor 构造函数自定义参数的方式来创建线程池。
ThreadPoolExecutorDemo.java
1 | import java.util.concurrent.ArrayBlockingQueue; |
可以看到我们上面的代码指定了:
corePoolSize: 核心线程数为 5。maximumPoolSize:最大线程数 10keepAliveTime: 等待时间为 1L。unit: 等待时间的单位为 TimeUnit.SECONDS。workQueue:任务队列为ArrayBlockingQueue,并且容量为 100;handler:饱和策略为CallerRunsPolicy。
Output:
1 | pool-1-thread-3 Start. Time = Sun Apr 12 11:14:37 CST 2020 |
4.2 线程池原理分析
承接 4.1 节,我们通过代码输出结果可以看出:线程池首先会先执行 5 个任务,然后这些任务有任务被执行完的话,就会去拿新的任务执行。 大家可以先通过上面讲解的内容,分析一下到底是咋回事?(自己独立思考一会)
现在,我们就分析上面的输出内容来简单分析一下线程池原理。
为了搞懂线程池的原理,我们需要首先分析一下 execute方法。 在 4.1 节中的 Demo 中我们使用 executor.execute(worker)来提交一个任务到线程池中去,这个方法非常重要,下面我们来看看它的源码:
1 | // 存放线程池的运行状态 (runState) 和线程池内有效线程的数量 (workerCount) |
通过下图可以更好的对上面这 3 步做一个展示,下图是我为了省事直接从网上找到,原地址不明。
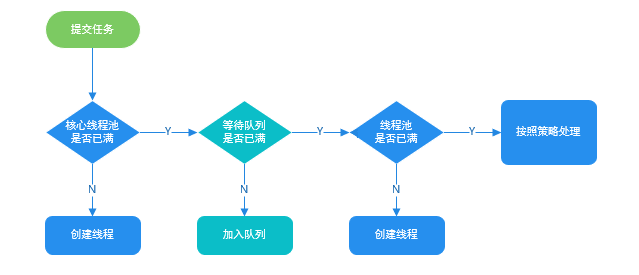
addWorker 这个方法主要用来创建新的工作线程,如果返回 true 说明创建和启动工作线程成功,否则的话返回的就是 false。
1 | // 全局锁,并发操作必备 |
更多关于线程池源码分析的内容推荐这篇文章:《JUC 线程池 ThreadPoolExecutor 源码分析》
现在,让我们在回到 4.1 节我们写的 Demo, 现在应该是不是很容易就可以搞懂它的原理了呢?
没搞懂的话,也没关系,可以看看我的分析:
我们在代码中模拟了 10 个任务,我们配置的核心线程数为 5 、等待队列容量为 100 ,所以每次只可能存在 5 个任务同时执行,剩下的 5 个任务会被放到等待队列中去。当前的 5 个任务中如果有任务被执行完了,线程池就会去拿新的任务执行。
4.3 几个常见的对比
4.3.1 Runnable vs Callable
Runnable自 Java 1.0 以来一直存在,但Callable仅在 Java 1.5 中引入,目的就是为了来处理Runnable不支持的用例。**Runnable 接口**不会返回结果或抛出检查异常,但是 Callable 接口可以。所以,如果任务不需要返回结果或抛出异常推荐使用 Runnable 接口,这样代码看起来会更加简洁。
工具类 Executors 可以实现将 Runnable 对象转换成 Callable 对象。(Executors.callable(Runnable task) 或 Executors.callable(Runnable task, Object result))。
Runnable.java
1 | interface Runnable { /** * 被线程执行,没有返回值也无法抛出异常 */ public abstract void run();} |
Callable.java
1 | interface Callable<V> { /** * 计算结果,或在无法这样做时抛出异常。 * @return 计算得出的结果 * @throws 如果无法计算结果,则抛出异常 */ V call() throws Exception;} |
4.3.2 execute() vs submit()
execute()方法用于提交不需要返回值的任务,所以无法判断任务是否被线程池执行成功与否;submit()方法用于提交需要返回值的任务。线程池会返回一个Future类型的对象,通过这个Future对象可以判断任务是否执行成功,并且可以通过Future的get()方法来获取返回值,get()方法会阻塞当前线程直到任务完成,而使用get(long timeout,TimeUnit unit)方法则会阻塞当前线程一段时间后立即返回,这时候有可能任务没有执行完。
我们以 AbstractExecutorService 接口中的一个 submit() 方法为例子来看看源代码:
1 | public Future<?> submit(Runnable task) { if (task == null) throw new NullPointerException(); RunnableFuture<Void> ftask = newTaskFor(task, null); execute(ftask); return ftask; } |
上面方法调用的 newTaskFor 方法返回了一个 FutureTask 对象。
1 | protected <T> RunnableFuture<T> newTaskFor(Runnable runnable, T value) { return new FutureTask<T>(runnable, value); } |
我们再来看看execute()方法:
1 | public void execute(Runnable command) { ... } |
4.3.3 shutdown()VSshutdownNow()
shutdown():关闭线程池,线程池的状态变为SHUTDOWN。线程池不再接受新任务了,但是队列里的任务得执行完毕。shutdownNow():关闭线程池,线程的状态变为STOP。线程池会终止当前正在运行的任务,并停止处理排队的任务并返回正在等待执行的 List。
4.3.2 isTerminated() VS isShutdown()
isShutDown当调用shutdown()方法后返回为 true。isTerminated当调用shutdown()方法后,并且所有提交的任务完成后返回为 true
4.4 加餐:Callable+ThreadPoolExecutor示例代码
MyCallable.java
1 | import java.util.concurrent.Callable;public class MyCallable implements Callable<String> { public String call() throws Exception { Thread.sleep(1000); //返回执行当前 Callable 的线程名字 return Thread.currentThread().getName(); }} |
CallableDemo.java
1 | import java.util.ArrayList;import java.util.Date;import java.util.List;import java.util.concurrent.ArrayBlockingQueue;import java.util.concurrent.Callable;import java.util.concurrent.ExecutionException;import java.util.concurrent.Future;import java.util.concurrent.ThreadPoolExecutor;import java.util.concurrent.TimeUnit;public class CallableDemo { private static final int CORE_POOL_SIZE = 5; private static final int MAX_POOL_SIZE = 10; private static final int QUEUE_CAPACITY = 100; private static final Long KEEP_ALIVE_TIME = 1L; public static void main(String[] args) { //使用阿里巴巴推荐的创建线程池的方式 //通过ThreadPoolExecutor构造函数自定义参数创建 ThreadPoolExecutor executor = new ThreadPoolExecutor( CORE_POOL_SIZE, MAX_POOL_SIZE, KEEP_ALIVE_TIME, TimeUnit.SECONDS, new ArrayBlockingQueue<>(QUEUE_CAPACITY), new ThreadPoolExecutor.CallerRunsPolicy()); List<Future<String>> futureList = new ArrayList<>(); Callable<String> callable = new MyCallable(); for (int i = 0; i < 10; i++) { //提交任务到线程池 Future<String> future = executor.submit(callable); //将返回值 future 添加到 list,我们可以通过 future 获得 执行 Callable 得到的返回值 futureList.add(future); } for (Future<String> fut : futureList) { try { System.out.println(new Date() + "::" + fut.get()); } catch (InterruptedException | ExecutionException e) { e.printStackTrace(); } } //关闭线程池 executor.shutdown(); }} |
Output:
1 | Wed Nov 13 13:40:41 CST 2019::pool-1-thread-1Wed Nov 13 13:40:42 CST 2019::pool-1-thread-2Wed Nov 13 13:40:42 CST 2019::pool-1-thread-3Wed Nov 13 13:40:42 CST 2019::pool-1-thread-4Wed Nov 13 13:40:42 CST 2019::pool-1-thread-5Wed Nov 13 13:40:42 CST 2019::pool-1-thread-3Wed Nov 13 13:40:43 CST 2019::pool-1-thread-2Wed Nov 13 13:40:43 CST 2019::pool-1-thread-1Wed Nov 13 13:40:43 CST 2019::pool-1-thread-4Wed Nov 13 13:40:43 CST 2019::pool-1-thread-5 |
五 几种常见的线程池详解
5.1 FixedThreadPool
5.1.1 介绍
FixedThreadPool 被称为可重用固定线程数的线程池。通过 Executors 类中的相关源代码来看一下相关实现:
1 | /** * 创建一个可重用固定数量线程的线程池 */ public static ExecutorService newFixedThreadPool(int nThreads, ThreadFactory threadFactory) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>(), threadFactory); } |
另外还有一个 FixedThreadPool 的实现方法,和上面的类似,所以这里不多做阐述:
1 | public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } |
从上面源代码可以看出新创建的 FixedThreadPool 的 corePoolSize 和 maximumPoolSize 都被设置为 nThreads,这个 nThreads 参数是我们使用的时候自己传递的。
5.1.2 执行任务过程介绍
FixedThreadPool 的 execute() 方法运行示意图(该图片来源:《Java 并发编程的艺术》):

上图说明:
- 如果当前运行的线程数小于 corePoolSize, 如果再来新任务的话,就创建新的线程来执行任务;
- 当前运行的线程数等于 corePoolSize 后, 如果再来新任务的话,会将任务加入
LinkedBlockingQueue; - 线程池中的线程执行完 手头的任务后,会在循环中反复从
LinkedBlockingQueue中获取任务来执行;
5.1.3 为什么不推荐使用FixedThreadPool?
FixedThreadPool 使用无界队列 LinkedBlockingQueue(队列的容量为 Integer.MAX_VALUE)作为线程池的工作队列会对线程池带来如下影响 :
- 当线程池中的线程数达到
corePoolSize后,新任务将在无界队列中等待,因此线程池中的线程数不会超过 corePoolSize; - 由于使用无界队列时
maximumPoolSize将是一个无效参数,因为不可能存在任务队列满的情况。所以,通过创建FixedThreadPool的源码可以看出创建的FixedThreadPool的corePoolSize和maximumPoolSize被设置为同一个值。 - 由于 1 和 2,使用无界队列时
keepAliveTime将是一个无效参数; - 运行中的
FixedThreadPool(未执行shutdown()或shutdownNow())不会拒绝任务,在任务比较多的时候会导致 OOM(内存溢出)。
5.2 SingleThreadExecutor 详解
5.2.1 介绍
SingleThreadExecutor 是只有一个线程的线程池。下面看看SingleThreadExecutor 的实现:
1 | /** *返回只有一个线程的线程池 */ public static ExecutorService newSingleThreadExecutor(ThreadFactory threadFactory) { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>(), threadFactory)); } |
1 | public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); } |
从上面源代码可以看出新创建的 SingleThreadExecutor 的 corePoolSize 和 maximumPoolSize 都被设置为 1.其他参数和 FixedThreadPool 相同。
5.2.2 执行任务过程介绍
SingleThreadExecutor 的运行示意图(该图片来源:《Java 并发编程的艺术》):
上图说明 :
- 如果当前运行的线程数少于
corePoolSize,则创建一个新的线程执行任务; - 当前线程池中有一个运行的线程后,将任务加入
LinkedBlockingQueue - 线程执行完当前的任务后,会在循环中反复从
LinkedBlockingQueue中获取任务来执行;
5.2.3 为什么不推荐使用SingleThreadExecutor?
SingleThreadExecutor 使用无界队列 LinkedBlockingQueue 作为线程池的工作队列(队列的容量为 Intger.MAX_VALUE)。SingleThreadExecutor 使用无界队列作为线程池的工作队列会对线程池带来的影响与 FixedThreadPool 相同。说简单点就是可能会导致 OOM,
5.3 CachedThreadPool 详解
5.3.1 介绍
CachedThreadPool 是一个会根据需要创建新线程的线程池。下面通过源码来看看 CachedThreadPool 的实现:
1 | /** |
1 | public static ExecutorService newCachedThreadPool() { |
CachedThreadPool 的corePoolSize 被设置为空(0),maximumPoolSize被设置为 Integer.MAX.VALUE,即它是无界的,这也就意味着如果主线程提交任务的速度高于 maximumPool 中线程处理任务的速度时,CachedThreadPool 会不断创建新的线程。极端情况下,这样会导致耗尽 cpu 和内存资源。
5.3.2 执行任务过程介绍
CachedThreadPool 的 execute() 方法的执行示意图(该图片来源:《Java 并发编程的艺术》):
上图说明:
- 首先执行
SynchronousQueue.offer(Runnable task)提交任务到任务队列。如果当前maximumPool中有闲线程正在执行SynchronousQueue.poll(keepAliveTime,TimeUnit.NANOSECONDS),那么主线程执行 offer 操作与空闲线程执行的poll操作配对成功,主线程把任务交给空闲线程执行,execute()方法执行完成,否则执行下面的步骤 2; - 当初始
maximumPool为空,或者maximumPool中没有空闲线程时,将没有线程执行SynchronousQueue.poll(keepAliveTime,TimeUnit.NANOSECONDS)。这种情况下,步骤 1 将失败,此时CachedThreadPool会创建新线程执行任务,execute 方法执行完成;
5.3.3 为什么不推荐使用CachedThreadPool?
CachedThreadPool允许创建的线程数量为 Integer.MAX_VALUE ,可能会创建大量线程,从而导致 OOM。
六 ScheduledThreadPoolExecutor 详解
ScheduledThreadPoolExecutor 主要用来在给定的延迟后运行任务,或者定期执行任务。 这个在实际项目中基本不会被用到,也不推荐使用,大家只需要简单了解一下它的思想即可。
6.1 简介
ScheduledThreadPoolExecutor 使用的任务队列 DelayQueue 封装了一个 PriorityQueue,PriorityQueue 会对队列中的任务进行排序,执行所需时间短的放在前面先被执行(ScheduledFutureTask 的 time 变量小的先执行),如果执行所需时间相同则先提交的任务将被先执行(ScheduledFutureTask 的 squenceNumber 变量小的先执行)。
ScheduledThreadPoolExecutor 和 Timer 的比较:
Timer对系统时钟的变化敏感,ScheduledThreadPoolExecutor不是;Timer只有一个执行线程,因此长时间运行的任务可以延迟其他任务。ScheduledThreadPoolExecutor可以配置任意数量的线程。 此外,如果你想(通过提供 ThreadFactory),你可以完全控制创建的线程;- 在
TimerTask中抛出的运行时异常会杀死一个线程,从而导致Timer死机:-( …即计划任务将不再运行。ScheduledThreadExecutor不仅捕获运行时异常,还允许您在需要时处理它们(通过重写afterExecute方法ThreadPoolExecutor)。抛出异常的任务将被取消,但其他任务将继续运行。
综上,在 JDK1.5 之后,你没有理由再使用 Timer 进行任务调度了。
关于定时任务的详细介绍,小伙伴们可以在 JavaGuide 的项目首页搜索“定时任务”找到对应的原创内容。
6.2 运行机制

ScheduledThreadPoolExecutor 的执行主要分为两大部分:
- 当调用
ScheduledThreadPoolExecutor的scheduleAtFixedRate()方法或者scheduleWithFixedDelay()方法时,会向ScheduledThreadPoolExecutor的DelayQueue添加一个实现了RunnableScheduledFuture接口的ScheduledFutureTask。 - 线程池中的线程从
DelayQueue中获取ScheduledFutureTask,然后执行任务。
ScheduledThreadPoolExecutor 为了实现周期性的执行任务,对 ThreadPoolExecutor做了如下修改:
- 使用
DelayQueue作为任务队列; - 获取任务的方不同
- 执行周期任务后,增加了额外的处理
6.3 ScheduledThreadPoolExecutor 执行周期任务的步骤

- 线程 1 从
DelayQueue中获取已到期的ScheduledFutureTask(DelayQueue.take())。到期任务是指ScheduledFutureTask的 time 大于等于当前系统的时间; - 线程 1 执行这个
ScheduledFutureTask; - 线程 1 修改
ScheduledFutureTask的 time 变量为下次将要被执行的时间; - 线程 1 把这个修改 time 之后的
ScheduledFutureTask放回DelayQueue中(DelayQueue.add())。
七 线程池大小确定
线程池数量的确定一直是困扰着程序员的一个难题,大部分程序员在设定线程池大小的时候就是随心而定。
很多人甚至可能都会觉得把线程池配置过大一点比较好!我觉得这明显是有问题的。就拿我们生活中非常常见的一例子来说:并不是人多就能把事情做好,增加了沟通交流成本。你本来一件事情只需要 3 个人做,你硬是拉来了 6 个人,会提升做事效率嘛?我想并不会。 线程数量过多的影响也是和我们分配多少人做事情一样,对于多线程这个场景来说主要是增加了上下文切换成本。不清楚什么是上下文切换的话,可以看我下面的介绍。
上下文切换:
多线程编程中一般线程的个数都大于 CPU 核心的个数,而一个 CPU 核心在任意时刻只能被一个线程使用,为了让这些线程都能得到有效执行,CPU 采取的策略是为每个线程分配时间片并轮转的形式。当一个线程的时间片用完的时候就会重新处于就绪状态让给其他线程使用,这个过程就属于一次上下文切换。概括来说就是:当前任务在执行完 CPU 时间片切换到另一个任务之前会先保存自己的状态,以便下次再切换回这个任务时,可以再加载这个任务的状态。任务从保存到再加载的过程就是一次上下文切换。
上下文切换通常是计算密集型的。也就是说,它需要相当可观的处理器时间,在每秒几十上百次的切换中,每次切换都需要纳秒量级的时间。所以,上下文切换对系统来说意味着消耗大量的 CPU 时间,事实上,可能是操作系统中时间消耗最大的操作。
Linux 相比与其他操作系统(包括其他类 Unix 系统)有很多的优点,其中有一项就是,其上下文切换和模式切换的时间消耗非常少。
类比于实现世界中的人类通过合作做某件事情,我们可以肯定的一点是线程池大小设置过大或者过小都会有问题,合适的才是最好。
如果我们设置的线程池数量太小的话,如果同一时间有大量任务/请求需要处理,可能会导致大量的请求/任务在任务队列中排队等待执行,甚至会出现任务队列满了之后任务/请求无法处理的情况,或者大量任务堆积在任务队列导致 OOM。这样很明显是有问题的! CPU 根本没有得到充分利用。
但是,如果我们设置线程数量太大,大量线程可能会同时在争取 CPU 资源,这样会导致大量的上下文切换,从而增加线程的执行时间,影响了整体执行效率。
有一个简单并且适用面比较广的公式:
- CPU 密集型任务(N+1): 这种任务消耗的主要是 CPU 资源,可以将线程数设置为 N(CPU 核心数)+1,比 CPU 核心数多出来的一个线程是为了防止线程偶发的缺页中断,或者其它原因导致的任务暂停而带来的影响。一旦任务暂停,CPU 就会处于空闲状态,而在这种情况下多出来的一个线程就可以充分利用 CPU 的空闲时间。
- I/O 密集型任务(2N): 这种任务应用起来,系统会用大部分的时间来处理 I/O 交互,而线程在处理 I/O 的时间段内不会占用 CPU 来处理,这时就可以将 CPU 交出给其它线程使用。因此在 I/O 密集型任务的应用中,我们可以多配置一些线程,具体的计算方法是 2N。
如何判断是 CPU 密集任务还是 IO 密集任务?
CPU 密集型简单理解就是利用 CPU 计算能力的任务比如你在内存中对大量数据进行排序。但凡涉及到网络读取,文件读取这类都是 IO 密集型,这类任务的特点是 CPU 计算耗费时间相比于等待 IO 操作完成的时间来说很少,大部分时间都花在了等待 IO 操作完成上。
线程池知识回顾
开始这篇文章之前还是简单介绍一嘴线程池,之前写的《新手也能看懂的线程池学习总结》这篇文章介绍的很详细了。
为什么要使用线程池?
池化技术想必大家已经屡见不鲜了,线程池、数据库连接池、Http 连接池等等都是对这个思想的应用。池化技术的思想主要是为了减少每次获取资源的消耗,提高对资源的利用率。
线程池提供了一种限制和管理资源(包括执行一个任务)。 每个线程池还维护一些基本统计信息,例如已完成任务的数量。
这里借用《Java 并发编程的艺术》提到的来说一下使用线程池的好处:
- 降低资源消耗。通过重复利用已创建的线程降低线程创建和销毁造成的消耗。
- 提高响应速度。当任务到达时,任务可以不需要等到线程创建就能立即执行。
- 提高线程的可管理性。线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一的分配,调优和监控。
线程池在实际项目的使用场景
线程池一般用于执行多个不相关联的耗时任务,没有多线程的情况下,任务顺序执行,使用了线程池的话可让多个不相关联的任务同时执行。
假设我们要执行三个不相关的耗时任务,Guide 画图给大家展示了使用线程池前后的区别。
注意:下面三个任务可能做的是同一件事情,也可能是不一样的事情。

如何使用线程池?
一般是通过 ThreadPoolExecutor 的构造函数来创建线程池,然后提交任务给线程池执行就可以了。
ThreadPoolExecutor构造函数如下:
1 | /** |
简单演示一下如何使用线程池,更详细的介绍,请看:《新手也能看懂的线程池学习总结》 。
1 | private static final int CORE_POOL_SIZE = 5; |
控制台输出:
1 | CurrentThread name:pool-1-thread-5date:2020-06-06T11:45:31.639Z |
线程池最佳实践
简单总结一下我了解的使用线程池的时候应该注意的东西,网上似乎还没有专门写这方面的文章。
因为Guide还比较菜,有补充和完善的地方,可以在评论区告知或者在微信上与我交流。
1. 使用 ThreadPoolExecutor 的构造函数声明线程池
1. 线程池必须手动通过 ThreadPoolExecutor 的构造函数来声明,避免使用Executors 类的 newFixedThreadPool 和 newCachedThreadPool ,因为可能会有 OOM 的风险。
Executors 返回线程池对象的弊端如下:
FixedThreadPool和SingleThreadExecutor: 允许请求的队列长度为Integer.MAX_VALUE,可能堆积大量的请求,从而导致 OOM。- CachedThreadPool 和 ScheduledThreadPool : 允许创建的线程数量为
Integer.MAX_VALUE,可能会创建大量线程,从而导致 OOM。
说白了就是:使用有界队列,控制线程创建数量。
除了避免 OOM 的原因之外,不推荐使用 Executors 提供的两种快捷的线程池的原因还有:
- 实际使用中需要根据自己机器的性能、业务场景来手动配置线程池的参数比如核心线程数、使用的任务队列、饱和策略等等。
- 我们应该显示地给我们的线程池命名,这样有助于我们定位问题。
2.监测线程池运行状态
你可以通过一些手段来检测线程池的运行状态比如 SpringBoot 中的 Actuator 组件。
除此之外,我们还可以利用 ThreadPoolExecutor 的相关 API做一个简陋的监控。从下图可以看出, ThreadPoolExecutor提供了获取线程池当前的线程数和活跃线程数、已经执行完成的任务数、正在排队中的任务数等等。

下面是一个简单的 Demo。printThreadPoolStatus()会每隔一秒打印出线程池的线程数、活跃线程数、完成的任务数、以及队列中的任务数。
1 | /** |
3.建议不同类别的业务用不同的线程池
很多人在实际项目中都会有类似这样的问题:我的项目中多个业务需要用到线程池,是为每个线程池都定义一个还是说定义一个公共的线程池呢?
一般建议是不同的业务使用不同的线程池,配置线程池的时候根据当前业务的情况对当前线程池进行配置,因为不同的业务的并发以及对资源的使用情况都不同,重心优化系统性能瓶颈相关的业务。
我们再来看一个真实的事故案例! (本案例来源自:《线程池运用不当的一次线上事故》 ,很精彩的一个案例)

上面的代码可能会存在死锁的情况,为什么呢?画个图给大家捋一捋。
试想这样一种极端情况:假如我们线程池的核心线程数为 n,父任务(扣费任务)数量为 n,父任务下面有两个子任务(扣费任务下的子任务),其中一个已经执行完成,另外一个被放在了任务队列中。由于父任务把线程池核心线程资源用完,所以子任务因为无法获取到线程资源无法正常执行,一直被阻塞在队列中。父任务等待子任务执行完成,而子任务等待父任务释放线程池资源,这也就造成了 **”死锁”**。

解决方法也很简单,就是新增加一个用于执行子任务的线程池专门为其服务。
4.别忘记给线程池命名
初始化线程池的时候需要显示命名(设置线程池名称前缀),有利于定位问题。
默认情况下创建的线程名字类似 pool-1-thread-n 这样的,没有业务含义,不利于我们定位问题。
给线程池里的线程命名通常有下面两种方式:
**1.利用 guava 的 ThreadFactoryBuilder **
1 | ThreadFactory threadFactory = new ThreadFactoryBuilder() |
2.自己实现 ThreadFactor。
1 | import java.util.concurrent.Executors; |
5.正确配置线程池参数
说到如何给线程池配置参数,美团的骚操作至今让我难忘(后面会提到)!
我们先来看一下各种书籍和博客上一般推荐的配置线程池参数的方式,可以作为参考!
常规操作
很多人甚至可能都会觉得把线程池配置过大一点比较好!我觉得这明显是有问题的。就拿我们生活中非常常见的一例子来说:并不是人多就能把事情做好,增加了沟通交流成本。你本来一件事情只需要 3 个人做,你硬是拉来了 6 个人,会提升做事效率嘛?我想并不会。 线程数量过多的影响也是和我们分配多少人做事情一样,对于多线程这个场景来说主要是增加了上下文切换成本。不清楚什么是上下文切换的话,可以看我下面的介绍。
上下文切换:
多线程编程中一般线程的个数都大于 CPU 核心的个数,而一个 CPU 核心在任意时刻只能被一个线程使用,为了让这些线程都能得到有效执行,CPU 采取的策略是为每个线程分配时间片并轮转的形式。当一个线程的时间片用完的时候就会重新处于就绪状态让给其他线程使用,这个过程就属于一次上下文切换。概括来说就是:当前任务在执行完 CPU 时间片切换到另一个任务之前会先保存自己的状态,以便下次再切换回这个任务时,可以再加载这个任务的状态。任务从保存到再加载的过程就是一次上下文切换。
上下文切换通常是计算密集型的。也就是说,它需要相当可观的处理器时间,在每秒几十上百次的切换中,每次切换都需要纳秒量级的时间。所以,上下文切换对系统来说意味着消耗大量的 CPU 时间,事实上,可能是操作系统中时间消耗最大的操作。
Linux 相比与其他操作系统(包括其他类 Unix 系统)有很多的优点,其中有一项就是,其上下文切换和模式切换的时间消耗非常少。
类比于实现世界中的人类通过合作做某件事情,我们可以肯定的一点是线程池大小设置过大或者过小都会有问题,合适的才是最好。
如果我们设置的线程池数量太小的话,如果同一时间有大量任务/请求需要处理,可能会导致大量的请求/任务在任务队列中排队等待执行,甚至会出现任务队列满了之后任务/请求无法处理的情况,或者大量任务堆积在任务队列导致 OOM。这样很明显是有问题的! CPU 根本没有得到充分利用。
但是,如果我们设置线程数量太大,大量线程可能会同时在争取 CPU 资源,这样会导致大量的上下文切换,从而增加线程的执行时间,影响了整体执行效率。
有一个简单并且适用面比较广的公式:
- CPU 密集型任务(N+1): 这种任务消耗的主要是 CPU 资源,可以将线程数设置为 N(CPU 核心数)+1,比 CPU 核心数多出来的一个线程是为了防止线程偶发的缺页中断,或者其它原因导致的任务暂停而带来的影响。一旦任务暂停,CPU 就会处于空闲状态,而在这种情况下多出来的一个线程就可以充分利用 CPU 的空闲时间。
- I/O 密集型任务(2N): 这种任务应用起来,系统会用大部分的时间来处理 I/O 交互,而线程在处理 I/O 的时间段内不会占用 CPU 来处理,这时就可以将 CPU 交出给其它线程使用。因此在 I/O 密集型任务的应用中,我们可以多配置一些线程,具体的计算方法是 2N。
如何判断是 CPU 密集任务还是 IO 密集任务?
CPU 密集型简单理解就是利用 CPU 计算能力的任务比如你在内存中对大量数据进行排序。但凡涉及到网络读取,文件读取这类都是 IO 密集型,这类任务的特点是 CPU 计算耗费时间相比于等待 IO 操作完成的时间来说很少,大部分时间都花在了等待 IO 操作完成上。
美团的骚操作
美团技术团队在《Java线程池实现原理及其在美团业务中的实践》这篇文章中介绍到对线程池参数实现可自定义配置的思路和方法。
美团技术团队的思路是主要对线程池的核心参数实现自定义可配置。这三个核心参数是:
corePoolSize: 核心线程数线程数定义了最小可以同时运行的线程数量。maximumPoolSize: 当队列中存放的任务达到队列容量的时候,当前可以同时运行的线程数量变为最大线程数。workQueue: 当新任务来的时候会先判断当前运行的线程数量是否达到核心线程数,如果达到的话,新任务就会被存放在队列中。
为什么是这三个参数?
我在这篇《新手也能看懂的线程池学习总结》 中就说过这三个参数是 ThreadPoolExecutor 最重要的参数,它们基本决定了线程池对于任务的处理策略。
如何支持参数动态配置? 且看 ThreadPoolExecutor 提供的下面这些方法。

格外需要注意的是corePoolSize, 程序运行期间的时候,我们调用 setCorePoolSize() 这个方法的话,线程池会首先判断当前工作线程数是否大于corePoolSize,如果大于的话就会回收工作线程。
另外,你也看到了上面并没有动态指定队列长度的方法,美团的方式是自定义了一个叫做 ResizableCapacityLinkedBlockIngQueue 的队列(主要就是把LinkedBlockingQueue的capacity 字段的final关键字修饰给去掉了,让它变为可变的)。
最终实现的可动态修改线程池参数效果如下。👏👏👏

还没看够?推荐 why神的《如何设置线程池参数?美团给出了一个让面试官虎躯一震的回答。》这篇文章,深度剖析,很不错哦!
sleep、wait、yield、join、await、park的作用
sleep
sleep方法是属于Thread类中的方法,sleep过程中线程不会释放锁,只会阻塞线程,让出cpu给其他线程,但是监控状态依然保持着,当指定的时间到了后又会自动进入cpu争夺(如果有锁但是没有释放,则立即恢复运行;如果没有锁,则会进入等待队列,等待cpu的调度),可中断,sleep给其他线程运行机会时不会考虑线程的优先级,因此会给低优先级的线程以运行机会
1 | /** |
1 | // 没有加sleep的情况下运行结果 |
说明在有锁的情况下,调用sleep方法不会释放锁,也就是不会退出cpu资源
说一下sleep(0)有什么用
sleep通常用在没有加锁的多线程上,Sleep(0)是指CPU交出当前线程的执行权,进入就绪队列,这个时候操作系统重新计算优先级,然后竞争cpu的使用权
应用场景:
- 如果当前线程比较耗时占用cpu资源,可以在结尾处加上sleep(0),这样可以提高整体的执行效率
- 保证线程同步,线程池工作的时候,主线程使用sleep(0)来等待线程池中所有线程都完成运行。当在线程池中的线程非常多的时候,使用该方法减少线程上下文的切换,节省cpu的开销
wait
wait方法是属于object类中,wait过程中线程会释放对象锁,只有当其他线程调用notify才能唤醒次线程。wait使用时必须先获取对象锁,即必须在synchronized修饰的代码块中使用,那么响应的notify方法同样必须在synchronized修饰的代码块中使用,如果没有在synchronized修饰的代码块中使用时3会抛出IllegalMonitorStateException的异常
wait方法用notify唤醒后不一定继续执行后续内容,因为wait会释放锁,然后进入等待池(WaitSet,是一个双向循环链表。在调用wait的时候,会做两件事,想将吱声加入到waitset中,然后释放掉对象锁持有的锁),在被notify唤醒后,进入锁池(EntryList,唤醒后加入到对象的moitor对象的EntryList中),这个时候会尝试获取该对象的锁,如果获取成功后才会接着按照wait方法之后路径继续执行,没有拿到锁就进入阻塞状态
虚假唤醒:notify/notifyAll时唤醒的线程并不一定是满足真正可以执行的条件了。比如对象o,不满足A条件时发出o.wait(),然后不满足条件B时也发出o.wait;然后条件B满足了,发出o.notify(),唤醒对象o的等待池里的对象,但是唤醒的线程有可能是因为条件A进入等待的线程,这时把他唤醒条件A还是不满足。这是底层系统决定的一个小遗憾。为了避免这种情况,判断调用o.wait()的条件时必须使用while,而不是if,这样在虚假唤醒后会继续判断是否满足A条件,不满足说明是虚假唤醒又会调用o.wait()。
moitor:是对象头监听锁的数据结构
1 | /** |
1 | // 没有加wait的情况下运行结果 |
yield
和sleep一样都是Thread类的方法,都是暂停当前正在执行的线程对象,不会释放资源锁,和sleep不同的是yield方法不会让线程进入阻塞状态,而是让线程重新进入就绪状态,它只需要等待重新获取cpu执行时间,所以yield()的线程有可能在进入到可执行状态后马上又被执行。还有一点和sleep不同的是yield方法只能使同优先级或更高优先级的线程有执行的机会,不会发生优先级重排。
1 | /** |
1 | // 没有加yield的情况下运行结果 |
join
等待调用join方法的线程结束之后,程序在继续执行,相当于让另一个线程加入当前线程,另一个线程执行完毕,在接着执行这个线程,相当于串行。一般用于等待异步线程执行完结果之后才能继续运行的场景。例如:主线程创建并启动了子线程,如果子线程中药进行大量耗时运算计算某个数据值,而主线程要获取这个数据值才能运行,这时要用到join方法。
1 | /** |
1 | // 没有加入join |
await
Condition的方法,用于线程的阻塞,是执行在代码块中,可以通过方法释放锁,在唤醒后就进入就绪状态
park
是LockSupport.park()调用的,但是真正调用者是Unsafe类的native方法。可以使用LockSupport.unpark()方法唤醒,然后一定会执行后续内容(但是wait方法用notify唤醒后不一定继续执行后续内容)。
park()可以在任意位置运行、不需要抛出异常。park在执行前执行了unpark()方法,线程不会被阻塞,直接跳过park,继续执行后续内容(而wait之前执行了notify方法,则直接抛出异常)
https://blog.csdn.net/weixin_43767015/article/details/107207643

参考文章:
https://blog.csdn.net/ywlmsm1224811/article/details/94022647
https://blog.csdn.net/asdasdasd123123123/article/details/107814280
说说线程的生命周期和状态?
Java 线程在运行的生命周期中的指定时刻只可能处于下面 6 种不同状态的其中一个状态(图源《Java 并发编程艺术》4.1.4 节)。
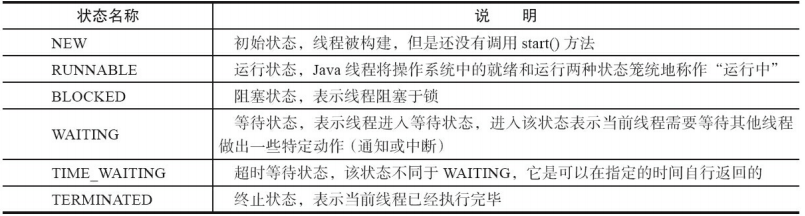
线程在生命周期中并不是固定处于某一个状态而是随着代码的执行在不同状态之间切换。Java 线程状态变迁如下图所示(图源《Java 并发编程艺术》4.1.4 节):
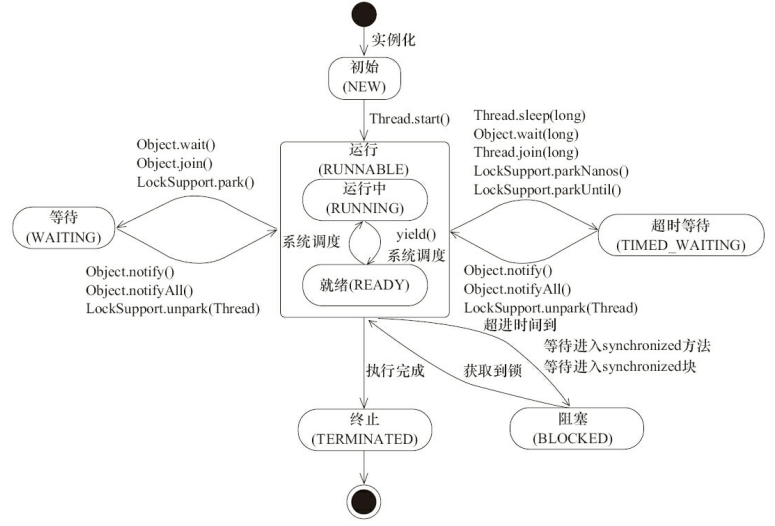
订正(来自issue736):原图中 wait 到 runnable 状态的转换中,
join实际上是Thread类的方法,但这里写成了Object。
由上图可以看出:线程创建之后它将处于 NEW(新建) 状态,调用 start() 方法后开始运行,线程这时候处于 READY(可运行) 状态。可运行状态的线程获得了 CPU 时间片(timeslice)后就处于 RUNNING(运行) 状态。
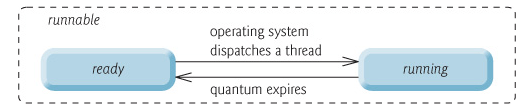
在操作系统中层面线程有 READY 和 RUNNING 状态,而在 JVM 层面只能看到 RUNNABLE 状态(图源:HowToDoInJava:Java Thread Life Cycle and Thread States),所以 Java 系统一般将这两个状态统称为 RUNNABLE(运行中) 状态 。
为什么 JVM 没有区分这两种状态呢? (摘自:java线程运行怎么有第六种状态? - Dawell的回答 ) 现在的时分(time-sharing)多任务(multi-task)操作系统架构通常都是用所谓的“时间分片(time quantum or time slice)”方式进行抢占式(preemptive)轮转调度(round-robin式)。这个时间分片通常是很小的,一个线程一次最多只能在 CPU 上运行比如 10-20ms 的时间(此时处于 running 状态),也即大概只有 0.01 秒这一量级,时间片用后就要被切换下来放入调度队列的末尾等待再次调度。(也即回到 ready 状态)。线程切换的如此之快,区分这两种状态就没什么意义了。
当线程执行 wait()方法之后,线程进入 WAITING(等待) 状态。进入等待状态的线程需要依靠其他线程的通知才能够返回到运行状态,而 TIMED_WAITING(超时等待) 状态相当于在等待状态的基础上增加了超时限制,比如通过 sleep(long millis)方法或 wait(long millis)方法可以将 Java 线程置于 TIMED_WAITING 状态。当超时时间到达后 Java 线程将会返回到 RUNNABLE 状态。当线程调用同步方法时,在没有获取到锁的情况下,线程将会进入到 BLOCKED(阻塞) 状态。线程在执行 Runnable 的run()方法之后将会进入到 TERMINATED(终止) 状态。
相关阅读:挑错 |《Java 并发编程的艺术》中关于线程状态的三处错误 。
java线程的状态及主要转化方式
操作系统中的线程状态转换和生命周期
线程的生命周期和java线程的转态:https://www.cnblogs.com/duanxz/p/3733179.html
首先我们来看看操作系统中的线程状态转换。
在现在的操作系统中,线程是被视为轻量级进程的,所以操作系统线程的状态其实和操作系统进程的状态是一致的。

系统进程/线程转换图
操作系统线程主要有以下三个状态:
- 就绪状态(ready):线程正在等待使用CPU,经调度程序调用之后可进入running状态。
- 执行状态(running):线程正在使用CPU。
- 等待状态(waiting): 线程经过等待事件的调用或者正在等待其他资源(如I/O)。
线程的生命周期:
新建(NEW)
- new关键字创建了一个线程之后,该线程就处于新建状态
- JVM为线程分配内存,初始化成员变量值
就绪(RUNNABLE)
- 当线程对象调用了start()方法之后,该线程处于就绪状态
- JVM为线程创建方法栈和程序计数器,等待线程调度器调度
运行(RUNNING)
- 就绪状态的线程获得CPU资源,开始运行run()方法,该线程进入运行状态
阻塞(BLOCKED)
当发生如下情况时,线程将会进入阻塞状态
线程调用sleep()方法主动放弃所占用的处理器资源
线程调用了一个阻塞式IO方法,在该方法返回之前,该线程被阻塞
线程试图获得一个同步锁(同步监视器),但该同步锁正被其他线程所持有。
线程在等待某个通知(notify)
程序调用了线程的suspend()方法将该线程挂起。但这个方法容易导致死锁,所以应该尽量避免使用该方法
死亡(TERMINTED)
线程会以如下3种方式结束,结束后就处于死亡状态:
run()或call()方法执行完成,线程正常结束
线程抛出一个未捕获的Exception或Error。
调用该线程stop()方法来结束该线程,该方法容易导致死锁,不推荐使用。
Java线程的6个状态


1 | // Thread.State 源码 |
NEW(新建)
处于NEW状态的线程此时尚未启动。这里的尚未启动指的是还没调用Thread实例的start()方法。
1 | private void testStateNew() { |
从上面可以看出,只是创建了线程而并没有调用start()方法,此时线程处于NEW状态。
关于start()的两个引申问题
- 反复调用同一个线程的start()方法是否可行?
- 假如一个线程执行完毕(此时处于TERMINATED状态),再次调用这个线程的start()方法是否可行?
要分析这两个问题,我们先来看看start()的源码:
1 | public synchronized void start() { |
我们可以看到,在start()内部,这里有一个threadStatus的变量。如果它不等于0,调用start()是会直接抛出异常的。
我们接着往下看,有一个native的start0()方法。这个方法里并没有对threadStatus的处理。到了这里我们仿佛就拿这个threadStatus没辙了,我们通过debug的方式再看一下:
1 |
|
我是在start()方法内部的最开始打的断点,叙述下在我这里打断点看到的结果:
- 第一次调用时threadStatus的值是0。
- 第二次调用时threadStatus的值不为0。
查看当前线程状态的源码:
1 | // Thread.getState方法源码: |
所以,我们结合上面的源码可以得到引申的两个问题的结果:
两个问题的答案都是不可行,在调用一次start()之后,threadStatus的值会改变(threadStatus !=0),此时再次调用start()方法会抛出IllegalThreadStateException异常。
比如,threadStatus为2代表当前线程状态为TERMINATED。
RUNNABLE(就绪和运行)
表示当前线程正在运行中。处于RUNNABLE状态的线程在Java虚拟机中运行,也有可能在等待其他系统资源(比如I/O)。
Java中线程的RUNNABLE状态
看了操作系统线程的几个状态之后我们来看看Thread源码里对RUNNABLE状态的定义:
1 | /** |
Java线程的RUNNABLE状态其实是包括了传统操作系统线程的ready和running两个状态的。
当调用线程对象的start()方法(t.start();),线程即进入就绪状态。处于就绪状态的线程,只是说明此线程已经做好了准备,随时等待CPU调度执行,并不是说执行了t.start()此线程立即就会执行;
因为就绪状态是进入运行状态的唯一入口,也就是说:在线程进入到运行状态执行,首先必须处于就绪状态,所以java把Runnable状态包括了传统的就绪和运行
BLOCKED(阻塞)
阻塞状态。处于BLOCKED状态的线程正等待锁的释放以进入同步区。
处于运行状态中的线程由于某种(当线程处于运行状态时,试图获得某个对象的同步锁时,如果该对象的同步锁已经被其他线程占用,Java虚拟机就会把这个线程放到这个对象的锁池中,这涉及到“线程同步”的内容。【线程在获取synchronized同步锁失败(因为锁被其它线程所占用)】)原因,暂时放弃对CPU的使用权,停止执行,此时进入阻塞状态,直到其进入到就绪状态,才有机会再次被CPU调用以进入到运行状态。
我们用BLOCKED状态举个生活中的例子:
假如今天你下班后准备去食堂吃饭。你来到食堂仅有的一个窗口,发现前面已经有个人在窗口前了,此时你必须得等前面的人从窗口离开才行。 假设你是线程t2,你前面的那个人是线程t1。此时t1占有了锁(食堂唯一的窗口),t2正在等待锁的释放,所以此时t2就处于BLOCKED状态。
WAITING(无限期等待)
等待状态。处于等待状态的线程变成RUNNABLE状态需要其他线程唤醒。
调用如下3个方法会使线程进入等待状态:
- 没有设置timeout参数的Object.wait():使当前线程处于等待状态直到另一个线程唤醒它;
- 没有设置timeout参数的Thread.join():等待线程执行完毕,底层调用的是Object实例的wait方法;
- LockSupport.park():除非获得调用许可,否则禁用当前线程进行线程调度。
我们延续上面的例子继续解释一下WAITING状态:
你等了好几分钟现在终于轮到你了,突然你们有一个“不懂事”的经理突然来了。你看到他你就有一种不祥的预感,果然,他是来找你的。
他把你拉到一旁叫你待会儿再吃饭,说他下午要去作报告,赶紧来找你了解一下项目的情况。你心里虽然有一万个不愿意但是你还是从食堂窗口走开了。
此时,假设你还是线程t2,你的经理是线程t1。虽然你此时都占有锁(窗口)了,“不速之客”来了你还是得释放掉锁。此时你t2的状态就是WAITING。然后经理t1获得锁,进入RUNNABLE状态。
要是经理t1不主动唤醒你t2(notify、notifyAll..),可以说你t2只能一直等待了。
TIMED_WAITING(限期等待)
超时等待状态。线程等待一个具体的时间,时间到后会被自动唤醒。
调用如下方法会使线程进入超时等待状态:
- Thread.sleep(long millis):使当前线程睡眠指定时间;
- 设置了timeout参数的Object.wait(long timeout):线程休眠指定时间,等待期间可以通过notify()/notifyAll()唤醒;
- 设置了timeout参数的Thread.join(long millis):等待当前线程最多执行millis毫秒,如果millis为0,则会一直执行;
- LockSupport.parkNanos(long nanos): 除非获得调用许可,否则禁用当前线程进行线程调度指定时间;
- LockSupport.parkUntil(long deadline):同上,也是禁止线程进行调度指定时间;
我们继续延续上面的例子来解释一下TIMED_WAITING状态:
到了第二天中午,又到了饭点,你还是到了窗口前。
突然间想起你的同事叫你等他一起,他说让你等他十分钟他改个bug。
好吧,你说那你就等等吧,你就离开了窗口。很快十分钟过去了,你见他还没来,你想都等了这么久了还不来,那你还是先去吃饭好了。
这时你还是线程t1,你改bug的同事是线程t2。t2让t1等待了指定时间,t1先主动释放了锁。此时t1等待期间就属于TIMED_WATING状态。
t1等待10分钟后,就自动唤醒,拥有了去争夺锁的资格。
TERMINATED(死亡)
终止状态。此时线程已执行完毕。
线程执行完了或者因异常退出了run()方法,该线程结束生命周期。
线程状态的转换
根据上面关于线程状态的介绍我们可以得到下面的线程状态转换图: 
BLOCKED与RUNNABLE状态的转换
我们在上面说到:处于BLOCKED状态的线程是因为在等待锁的释放。假如这里有两个线程a和b,a线程提前获得了锁并且暂未释放锁,此时b就处于BLOCKED状态。我们先来看一个例子:
1 |
|
初看之下,大家可能会觉得线程a会先调用同步方法,同步方法内又调用了Thread.sleep()方法,必然会输出TIMED_WAITING,而线程b因为等待线程a释放锁所以必然会输出BLOCKED。
其实不然,有两点需要值得大家注意,一是在测试方法blockedTest()内还有一个main线程,二是启动线程后执行run方法还是需要消耗一定时间的。不打断点的情况下,上面代码中都应该输出RUNNABLE。
测试方法的main线程只保证了a,b两个线程调用start()方法(转化为RUNNABLE状态),还没等两个线程真正开始争夺锁,就已经打印此时两个线程的状态(RUNNABLE)了。
这时你可能又会问了,要是我想要打印出BLOCKED状态我该怎么处理呢?其实就处理下测试方法里的main线程就可以了,你让它“休息一会儿”,打断点或者调用Thread.sleep方法就行。
这里需要注意的是main线程休息的时间,要保证在线程争夺锁的时间内,不要等到前一个线程锁都释放了你再去争夺锁,此时还是得不到BLOCKED状态的。
我们把上面的测试方法blockedTest()改动一下:
1 | public void blockedTest() throws InterruptedException { ······ a.start(); Thread.sleep(1000L); // 需要注意这里main线程休眠了1000毫秒,而testMethod()里休眠了2000毫秒 b.start(); System.out.println(a.getName() + ":" + a.getState()); // 输出? System.out.println(b.getName() + ":" + b.getState()); // 输出?} |
在这个例子中,由于main线程休眠,所以线程a的run()方法跟着执行,线程b再接着执行。
在线程a执行run()调用testMethod()之后,线程a休眠了2000ms(注意这里是没有释放锁的),main线程休眠完毕,接着b线程执行的时候是争夺不到锁的,所以这里输出:
1 | a:TIMED_WAITINGb:BLOCKED |
WAITING状态与RUNNABLE状态的转换
根据转换图我们知道有3个方法可以使线程从RUNNABLE状态转为WAITING状态。我们主要介绍下**Object.wait()和Thread.join()**。 Object.wait()
调用wait()方法前线程必须持有对象的锁。
线程调用wait()方法时,会释放当前的锁,直到有其他线程调用notify()/notifyAll()方法唤醒等待锁的线程。
需要注意的是,其他线程调用notify()方法只会唤醒单个等待锁的线程,如有有多个线程都在等待这个锁的话不一定会唤醒到之前调用wait()方法的线程。
同样,调用notifyAll()方法唤醒所有等待锁的线程之后,也不一定会马上把时间片分给刚才放弃锁的那个线程,具体要看系统的调度。
Thread.join()
调用join()方法不会释放锁,会一直等待当前线程执行完毕(转换为TERMINATED状态)。
我们再把上面的例子线程启动那里改变一下:
1 | public void blockedTest() { ······ a.start(); a.join(); b.start(); System.out.println(a.getName() + ":" + a.getState()); // 输出 TERMINATED System.out.println(b.getName() + ":" + b.getState());} |
要是没有调用join方法,main线程不管a线程是否执行完毕都会继续往下走。
a线程启动之后马上调用了join方法,这里main线程就会等到a线程执行完毕,所以这里a线程打印的状态固定是TERMIATED。
至于b线程的状态,有可能打印RUNNABLE(尚未进入同步方法),也有可能打印TIMED_WAITING(进入了同步方法)。
TIMED_WAITING与RUNNABLE状态转换
TIMED_WAITING与WAITING状态类似,只是TIMED_WAITING状态等待的时间是指定的。
Thread.sleep(long)
使当前线程睡眠指定时间。需要注意这里的“睡眠”只是暂时使线程停止执行,并不会释放锁。时间到后,线程会重新进入RUNNABLE状态。
Object.wait(long)
wait(long)方法使线程进入TIMED_WAITING状态。这里的wait(long)方法与无参方法wait()相同的地方是,都可以通过其他线程调用notify()或notifyAll()方法来唤醒。
不同的地方是,有参方法wait(long)就算其他线程不来唤醒它,经过指定时间long之后它会自动唤醒,拥有去争夺锁的资格。
Thread.join(long)
join(long)使当前线程执行指定时间,并且使线程进入TIMED_WAITING状态。
我们再来改一改刚才的示例:
这里调用a.join(1000L),因为是指定了具体a线程执行的时间的,并且执行时间是小于a线程sleep的时间,所以a线程状态输出TIMED_WAITING。
b线程状态仍然不固定(RUNNABLE或BLOCKED)。
线程中断
在某些情况下,我们在线程启动后发现并不需要它继续执行下去时,需要中断线程。目前在Java里还没有安全直接的方法来停止线程,但是Java提供了线程中断机制来处理需要中断线程的情况。
线程中断机制是一种协作机制。需要注意,通过中断操作并不能直接终止一个线程,而是通知需要被中断的线程自行处理。
简单介绍下Thread类里提供的关于线程中断的几个方法:
- Thread.interrupt():中断线程。这里的中断线程并不会立即停止线程,而是设置线程的中断状态为true(默认是flase);
- Thread.interrupted():测试当前线程是否被中断。线程的中断状态受这个方法的影响,意思是调用一次使线程中断状态设置为true,连续调用两次会使得这个线程的中断状态重新转为false;
- Thread.isInterrupted():测试当前线程是否被中断。与上面方法不同的是调用这个方法并不会影响线程的中断状态。
在线程中断机制里,当其他线程通知需要被中断的线程后,线程中断的状态被设置为true,但是具体被要求中断的线程要怎么处理,完全由被中断线程自己而定,可以在合适的实际处理中断请求,也可以完全不处理继续执行下去。
注意:
一般不推荐直接中断(interrupt)线程,而是让线程正常结束,如果发生了死锁(或者锁的时间特别长,需要打断),则使用interrupt()后,必须要在catch中处理,避免线程的数据不一致问题
锁
为什么需要加锁
多个线程对某个数据的操作,在大多数情况下都不是原子性的,例如多个线程同时进行i++;
第一个线程读取当前值为0,然后把0拿到自己的线程栈中进行操作,然后把操作后的数据放回原来的线程共享资源区
第二个线程在在第一个线程对数据++的时候,读取共享资源区的值,发现是0,然后把0拿到自己的线程栈中,进行++操作,然后写入线程共享资源区
这个时候,第一个线程i++后放回去为1,然后第二个线程又放回去也是1,就直接把原来的数据覆盖了,造成了多线程情况下的数据不一致
synchronized
一般用于加类锁、对象锁、方法锁,看上面案例(创建线程的几种方式)
jvm没有规定synchronized具体应该怎么实现,这个说hospot虚拟机中的synchronized底层实现
- 添加对象锁
- 第一种方法是锁的
new Object()对象 - 但是第一种方法比较麻烦,我们项目中通常使用
synchronized(this)
- 第一种方法是锁的
- 添加方法锁
- 在普通方法上上添加synchronized,相当于在本方法代码块中添加synchronized(this)
- 在类中的静态方法上加锁,没有this引用的存在,所以当锁一个静态方法的时候,相当于锁的事当前类的class对象
- 添加类锁
- 在static方法上添加synchronized,相当于在本方法代码块中添加synchronized(当前类.class)
- 在线程的
run方法上添加锁,相当于保证线程run方法的原子性,只有一个run方法的执行完毕后,另一个线程的run方法才能执行
使用主要事项(面试题)
synchronized方法能与非synchronized同时运行吗
能,但是会带来一些问题
如果在synchronized方法中调用非加锁方法,那么非加锁方法是不需要等待的,是一个异步执行,那么在这个方法中有可能会出现脏读,但是如果项目中对这个脏读数据不是特别看重,没有业务影响那么就不用管。如果有影响,那么这个非加锁方法需要加上synchronized,避免脏读,但是会减低效率。
synchronized是可冲入锁
一个synchronized方法可以调用另一个synchronized方法,如果是不可重入的,那么这个就发生死锁了。
一个synchronized方法可以调用另一个synchronized方法,第二个发现这是一个线程调用,那么就可重入,但是每加锁一次就要解锁一次。
同步方法和非同步方法是可以同时调用的
同步现异常,默认锁是会被释放的,会被其他线程运行**
synchronized不能锁基本数据类型和String(不推荐)


对业务写方法加锁,对业务读方法不加锁,容易产生脏读问题(读到了写过程中还没有完成的数据,或者回滚前的数据)
- 这个要具体看业务逻辑,是不需要绝对避免脏读,如果需要则需要添加读锁
出现异常情况下,默认情况下锁会被释放
如果一个synchronized方法中出现异常,会立即释放这个线程的锁(这个线程后续就不会执行了),然后其他线程就可能进入同步代码块,并且有可能访问到异常产生的数据
所以多线程中一定要做好异常处理
1
public class SynchronizedException { int count = 0; synchronized void m() { System.out.println(Thread.currentThread().getName() + " start"); for (int i = 0; i < 10; i++) { count++; System.out.println(Thread.currentThread().getName() + " count = " + count); try { TimeUnit.SECONDS.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); } if (count == 5) { int j = 1 / 0; //此处抛出异常,锁将会被释放。要想锁不被释放,可以在这里进行catch,然后循环继续 } } } public static void main(String[] args) { SynchronizedException se = new SynchronizedException(); Runnable r = new Runnable() { @Override public void run() { se.m(); } }; new Thread(r, "t1").start(); try { TimeUnit.SECONDS.sleep(2); } catch (InterruptedException e) { e.printStackTrace(); } new Thread(r, "t2").start(); }}
1
t1 startt1 count = 1t1 count = 2t1 count = 3t1 count = 4t1 count = 5// t1到这个地方就结束了,下面都是t2的执行t2 startt2 count = 6Exception in thread "t1" java.lang.ArithmeticException: / by zero at top.thread1.SynchronizedException.m(SynchronizedException.java:19) at top.thread1.SynchronizedException$1.run(SynchronizedException.java:31) at java.lang.Thread.run(Thread.java:745)t2 count = 7t2 count = 8t2 count = 9t2 count = 10t2 count = 11t2 count = 12t2 count = 13t2 count = 14t2 count = 15
volatile
volatile其实并不能称之为锁
volatile的作用主要是:
- 保证线程可见性(intel中的mesi,缓存一致性协议)
- 禁止指令重排(内存屏障)
注意:
只能保证线程的可见性(一个线程对共享变量的修改,另一个线程可以感知到),不能保证线程操作中的原子性(一个或者多个操作在 CPU 执行的过程中不被中断)
例如用volatile修饰一个变量i,执行i++操作,可见性是保证i被修改后立即通知其他线程,从主存中读取。但是i++的操作是不是原子性的
i++的过程分为三步:
- 从主存中读取i的值
- 对值进行计算
- 把最新的值写入内存
如果有多个线程同时读取了i的值都是0,这个时候都没有修改,所以都进行计算操作,这个时候就不是一个线程安全的操作,可能这一步后三个线程执行了i++,但是最后的结果都是1;
可见性
1 | /**volatile关键字,使一个变量在多个线程中可见;但是volatile并不能保证多个线程共同修改running变量时所带来不一致的问题,即volatile不能完全代替synchronized |

volatile不具备原子性
1 | /*10个线程分别执行10000次count++,count是对象vna的成员变量,按理来说最终count=100000, |
1 | thread0 count:16643 |
推荐文章:
可见性、有序性和原子性:https://zhuanlan.zhihu.com/p/296301631
https://blog.csdn.net/qq_32222165/article/details/106571793
synchronized保证的可见性和原子性
参考上面案例,在m方法加上synchronized方法,去掉原来的volatile
1 | thread0 count:10000thread7 count:20000thread6 count:30000thread5 count:40000thread4 count:50000thread3 count:60000thread1 count:70000thread2 count:80000thread9 count:90000thread8 count:100000100000 |
lock
ReentrantLock
在Java中通常实现锁有两种方式,一种是synchronized关键字,另一种是Lock。(synchronized在jdk1.5之后做了优化,性能提升了很多,只是使用ReentrantLock更灵活一些)。
synchronized本身就是一个可重入锁
| tips | synchronized(关键字) | Lock(接口) |
|---|---|---|
| 实现 | 基于JVM层面实现(JVM控制锁的获取和释放) | 基于JDK层面实现(我们可以借助JDK源码理解) |
| 使用 | 不用我们手动释放锁 | 需要手动上锁和释放锁(finally中unlock) |
| 锁获取超时 | 不支持。拿不到锁就一直在那等着,等到“死”。 | 支持。可以设置超时时间,时间过了没拿到就放弃,即Lock可以知道线程有没有拿到锁。 |
| 获取锁响应中断 | 不支持。 | 支持。可以设置是否可以被打断。 |
| 释放锁的条件 | 满足一个即可:①占有锁的线程执行完毕②占有锁的线程异常退出③占有锁的线程进入waiting状态释放锁 | 调用unlock()方法,或者时间到期 |
| 公平与否 | 非公平锁。(公平指的是哪个线程等的时间长就把锁交给谁) | 默认为非公平锁,可以设置为公平锁(排队等候)。 |
lockInteruptibly
ReentrantLock的中断和非中断加锁模式的区别在于:
:线程尝试获取锁操作失败后,在等待过程中,如果该线程被其他线程中断了,它是如何响应中断请求的。lock方法会忽略中断请求,继续获取锁直到成功;而lockInterruptibly则直接抛出中断异常来立即响应中断,由上层调用者处理中断。
lock()适用于锁获取操作不受中断影响的情况,此时可以忽略中断请求正常执行加锁操作,因为该操作仅仅记录了中断状态(通过Thread.currentThread().interrupt()操作,只是恢复了中断状态为true,并没有对中断进行响应)。
如果要求被中断线程不能参与锁的竞争操作,则此时应该使用lockInterruptibly方法,一旦检测到中断请求,立即返回不再参与锁的竞争并且取消锁获取操作(即finally中的cancelAcquire操作)
1 | /* * ReentrantLock可调用lockInterruptibly()方法,对线程的interrupt()方法作出响应,在一个线程等待的过程中,可以被打断。 * ReentrantLock的lock()方法是不能被打断的,即锁用lock()方法锁定,线程调用interrupt()方法是毫无作用的 * lock方法仅仅是加锁过程中不可中断 */public class ReentrantLockInterruptibly { public static void main(String[] args) { Lock lock = new ReentrantLock(); Thread t1 = new Thread(() -> { lock.lock(); try { System.out.print(" t1 start... "); TimeUnit.SECONDS.sleep(Integer.MAX_VALUE); //t1不停的运行,睡死了 System.out.print(" t1 end... "); } catch (InterruptedException e) { System.out.print(" t1-interrupted! "); } finally { lock.unlock(); } }); t1.start(); Thread t2 = new Thread(() -> { try { lock.lockInterruptibly(); try { // lock.lock(); //不能对interrupt()方法作出响应 System.out.print(" t2 start... "); TimeUnit.SECONDS.sleep(5); System.out.print(" t2 end... "); } catch (InterruptedException e) { e.printStackTrace(); } finally { lock.unlock(); } } catch (InterruptedException e) { System.out.println(" t2-interrupted! "); } }); t2.start(); try { TimeUnit.SECONDS.sleep(2); } catch (InterruptedException e) { e.printStackTrace(); } t1.interrupt(); //打断t1的等待 t2.interrupt(); //打断t2的等待 }} |
ReentrantLock可以指定为公平锁
参数为true的时候表示为公平锁
ReentrantLock lock = new ReentrantLock(true);
1 | /*ReentrantLock可以指定为公平锁,构造方法中将fair属性设置为true即为公平锁,fair默认为false*/public class ReentrantLockFair extends Thread { private static ReentrantLock lock = new ReentrantLock(true); //参数为true表示为公平锁,可对比输出结果 AtomicInteger count = new AtomicInteger(0); @Override public void run() { for (int i = 0; i < 5; i++) { lock.lock(); try { System.out.print(Thread.currentThread().getName() + "-获得锁; "); if (count.addAndGet(1) == 4) { count.set(0); System.out.println("\r"); } try { Thread.sleep(100); } catch (InterruptedException e) { e.printStackTrace(); } } finally { lock.unlock(); } } } public static void main(String[] args) { ReentrantLockFair r1 = new ReentrantLockFair(); // 这里我选择使用四个线程,因为我的处理器为4核,这样能够基本上保证一核处理一个线程,就是为了演示出公平和非公平 for (int i = 0; i < 4; i++) { new Thread(r1).start(); try { // 线程顺序启动 Thread.sleep(10); } catch (InterruptedException e) { e.printStackTrace(); } } }} |
1 | // 非公平锁 |